شركة OpenAI تطلق الإصدار الجديد من نموذج توليد الصور الخاص بها Images 2.0

أطلقت شركة OpenAI رسمياً نموذج توليد الصور ChatGPT Images 2.0، وذلك بعد حوالي العام تقريباً على إطلاق الإصدار الأول منه.

ووصفت الشركة النظام الجديد بأنه “نقلة نوعية” لنماذج توليد الصور، لا سيما فيما يتعلق بقدرة الأداة على اتباع التعليمات بدقة، وعرض النصوص الكثيفة، ووضع العناصر وربطها في المشهد.

ولأول مرة، طورت OpenAI نموذج صور يتمتع بقدرات استدلالية، مما يمنح النظام القدرة على القيام بأمور مثل البحث في الإنترنت والتحقق من مخرجاته.

ووفقًا للشركة، من شأن هذه القدرات أن تُترجم إلى أداة أكثر موثوقية عندما تكون الدقة والاتساق والتماسك البصري أمورًا أساسية.

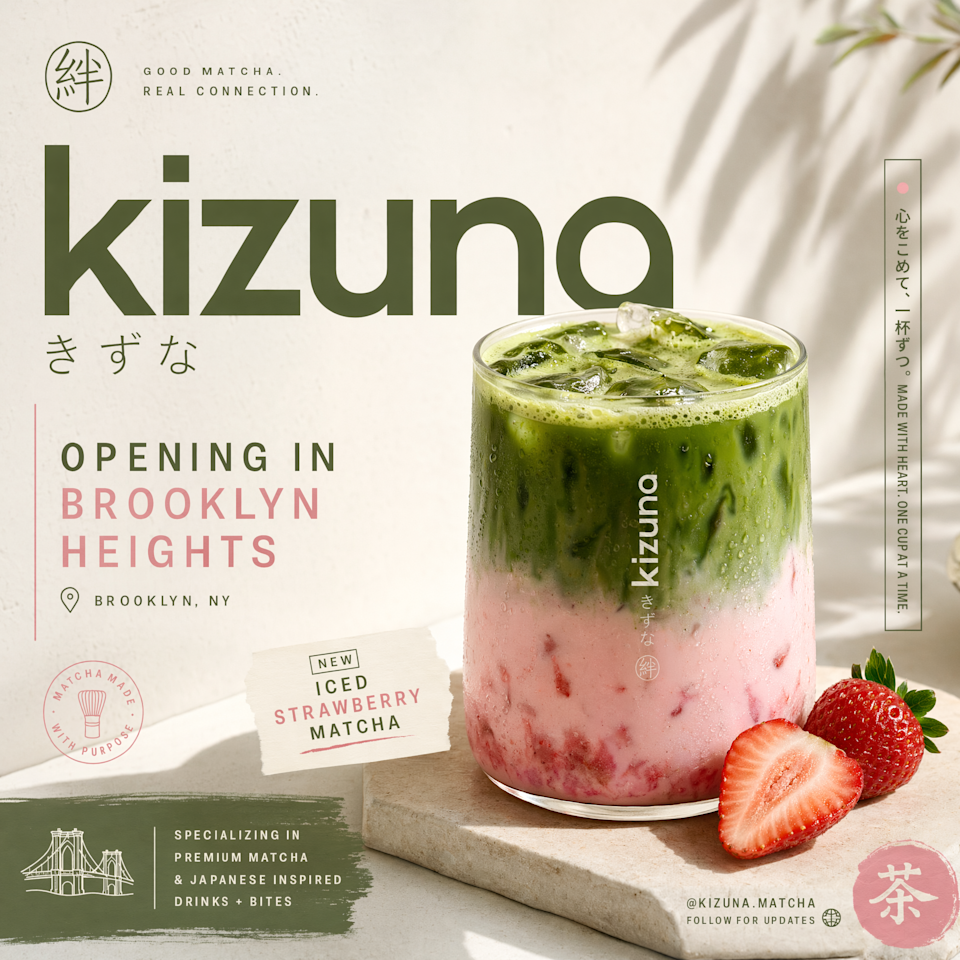
وأعلنت OpenAI أنها بذلت جهودًا كبيرة لتحسين أداء Images 2.0 في فهم وعرض النصوص غير اللاتينية، مع تحقيق “مكاسب ملحوظة” في قدرة النموذج على التعامل مع اللغات اليابانية والكورية والصينية والهندية والبنغالية.

وفي الوقت نفسه، تدّعي الشركة أن النموذج الجديد أكثر دقة في محاكاة الخصائص المميزة للغات البصرية المختلفة.

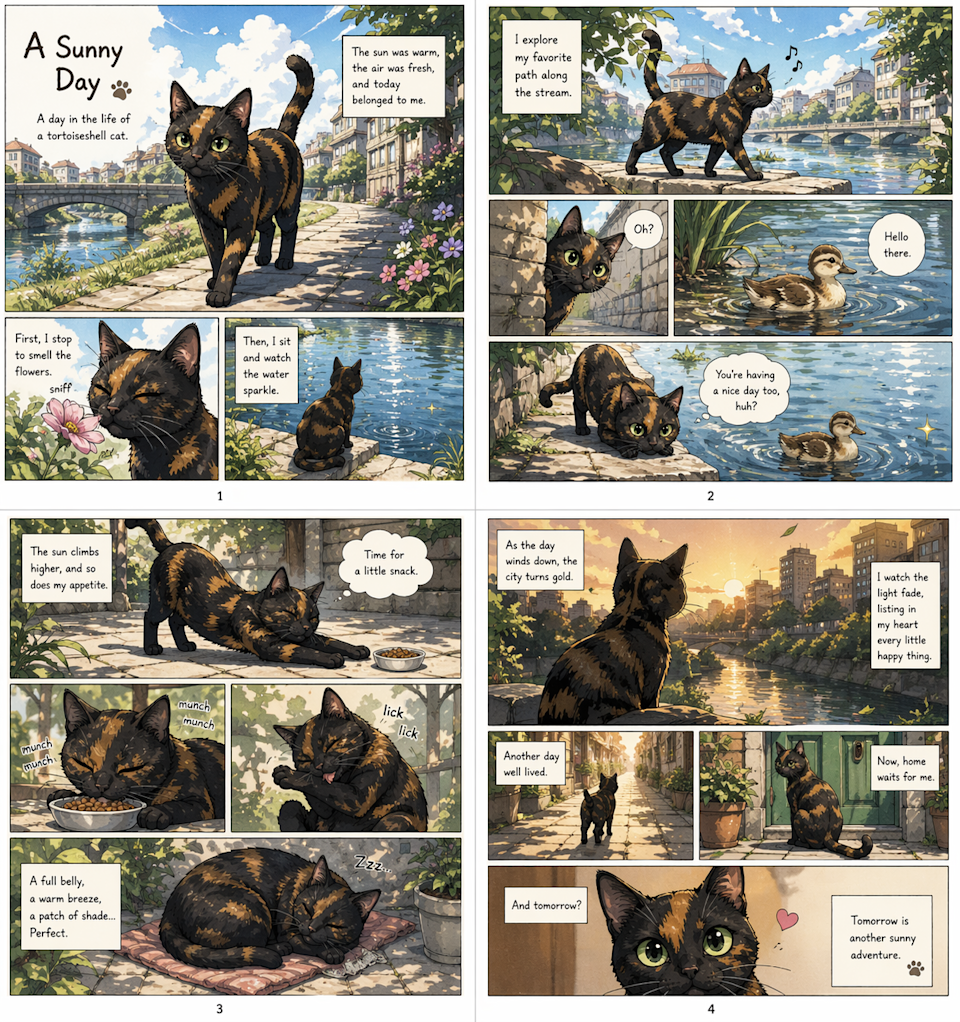
وتؤكد OpenAI أن هذا يجعل Images 2.0 أكثر فائدة في مهام مثل تصميم نماذج الألعاب ورسم القصص المصورة.

إلى جانب هذه الميزات، يتميز النموذج الجديد بمرونة أكبر فيما يتعلق بنسب العرض إلى الارتفاع، مما يسمح له بإنشاء صور بعرض يصل إلى 3:1 وارتفاع يصل إلى 1:3.

كما يمكنه إنتاج تصاميم بدقة تصل إلى 2K، بل ويمكنه توليد ما يصل إلى ثمانية مخرجات في عملية واحدة.

وسيتوفر نموذج Images 2.0 ابتداءً من اليوم لجميع مستخدمي ChatGPT، بما في ذلك المشتركين في الباقة المجانية وباقة Go.

ويحصل مشتركو باقتي Plus وPro على إمكانية الوصول إلى مخرجات أكثر تطورًا. كما تُتيح OpenAI النموذج عبر خدمة API وتطبيق Codex البرمجي، الذي تم تحديثه الأسبوع الماضي ليُوفر ميزة توليد الصور المدمجة.

والجدير بالذكر أن Images 2.0 تأتي بعد أيام قليلة من دخول Anthropic سوق التصميم المرئي بمساعد التصميم الخاص بها.

مقالات قد تعجبك

إنتل تكشف عن معالجاتها الجديد من سلسلة Core Series 3
سامسونج تطلق رسمياً تشكيلة تلفزيونات Micro RGB لعام 2026 بأحجام متنوعة
ميزة جديدة في يوتيوب لإخفاء مقاطع الفيديو القصيرة Shorts من الصفحة الرئيسية
جوجل ستضيف ميزة الذكاء الشخصي إلى نموذج توليد الصور Nano Banana 2

مايكروسوفت تكشف عن أول نموذج لها لتوليد الصور من الوصف النصي

أعلنت شركة مايكروسوفت Microsoft عن أول نموذج ذكاء اصطناعي لها لتحويل النص إلى صورة، تحت اسم MAI-Image-1، والذي تم تصميمه وتطويره داخليًا بالكامل.

ووصفت الشركة العملاقة هذا المولّد الجديد بأنه “الخطوة التالية في رحلتنا”، وذلك بعد إعلانها الأخير عن أول نماذج ذكاء اصطناعي داخلية من Microsoft.

وذكرت مايكروسوفت أنها استعانت بآراء محترفين في المجال الإبداعي لتجنب “المخرجات المتكررة أو ذات الطابع النمطي العام”.

وأكّدت الشركة أن MAI-Image-1 يتفوق في إنتاج صور فوتوغرافية واقعية مثل البرق والمناظر الطبيعية وغيرها، كما أنه قادر على معالجة الطلبات وتوليد الصور بسرعة تفوق “النماذج الأكبر والأبطأ”.

وقد حصل النموذج بالفعل على مركز ضمن أفضل 10 نماذج في موقع LMArena، وهو منصة تقييم لنماذج الذكاء الاصطناعي حيث يقارن المستخدمون بين المخرجات ويصوتون لأفضلها.

ينضم MAI-Image-1 إلى منتجات مايكروسوفت الأخرى للذكاء الاصطناعي، وهي مُولّد الصوت MAI-Voice-1 AI وروبوت المحادثة MAI-1-preview.

كانت مايكروسوفت من أوائل الممولين لـ OpenAI، إلا أن العلاقة بينهما ازدادت تعقيدًا، حيث بدأت مايكروسوفت مؤخرًا باستخدام نماذج الذكاء الاصطناعي من Anthropic لبعض ميزات Microsoft 365، وتستثمر بشكل كبير في تدريب نماذج الذكاء الاصطناعي الخاصة بها مثل MAI-Image-1.

مقالات قد تعجبك

تطبيق Sora يتجاوز حاجز المليون تحميل خلال أقل من خمسة أيام من إطلاقه
كروم ستقوم تلقائياً بتعطيل إشعارات المواقع غير المهمة
مايكروسوفت ستطلق تطبيق OneDrive على ويندوز
تطبيق Copilot سيتمكن من إنشاء مستندات أوفيس والربط مع Gmail