


كشفت إنفيديا عن توسعة جديدة لعائلة Nemotron 3.5، تضم نموذج Super VL للمهام التي تجمع النصوص والفهم البصري، إلى جانب نموذجَي Bolt الموجّهين للتشغيل المحلي. ووفق الإعلان الصادر في 15 أكتوبر 2026، أصبح Super VL وBolt 74B-A9B 24GB متاحين، بينما حُدد 23 أكتوبر لإتاحة Bolt E4B 4GB.
تركز الإصدارات على وكلاء الذكاء الاصطناعي الذين ينفذون سلسلة إجراءات، مثل قراءة مستند والبحث عن معلومات واستدعاء أداة ثم إعداد نتيجة. وتختلف النماذج في حجمها ومتطلبات تشغيلها، لتغطية استخدامات تمتد من بنية الشركات إلى الحواسيب والأجهزة الطرفية.
Super VL يجمع فهم النص والصورة والفيديو
بحسب بطاقة النموذج الرسمية، يضم Nemotron 3.5 Super VL نحو 120 مليار معلمة، مع تفعيل 12 ملياراً لكل رمز. ويستخدم بنية هجينة تجمع Mamba-2 وTransformer ومزيج الخبراء، إضافة إلى مكوّن للرؤية، ويدعم سياقاً يصل إلى مليون رمز.
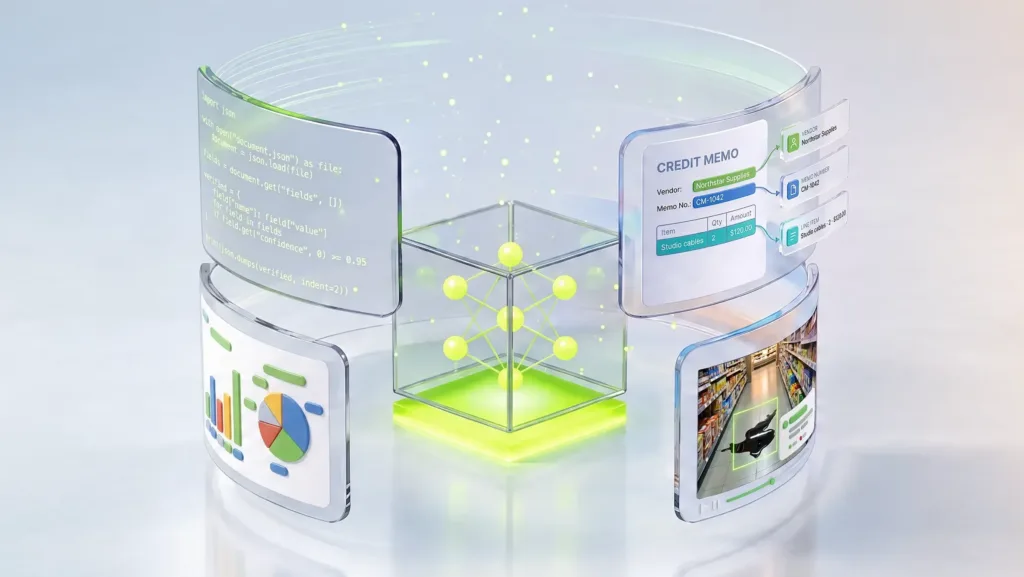
وتشمل مدخلاته النصوص والصور والفيديو، بينما ينتج نصوصاً. وتستهدف قدراته قراءة الجداول والرسوم البيانية واستخراج المعلومات من المستندات، إلى جانب الاستدلال والبرمجة واستخدام الأدوات. أما نسخة NVFP4 فتستخدم ضغطاً مختلط الدقة لتقليل متطلبات الذاكرة، وتورد البطاقة إعدادات تشغيل تشمل جهاز DGX Spark واحداً أو عتاداً مناسباً من فئة مراكز البيانات.
وتشرح المدونة التقنية لإنفيديا أن جمع هذه القدرات يتيح للوكيل تفسير رسم بياني وربطه بجدول في موضع آخر من المستند، ثم صياغة خلاصة تجمعهما. ويمكن للمؤسسات تخصيص هذا المسار وفق مستنداتها وأدواتها ومعايير التقييم الخاصة بها.

Bolt لتشغيل الوكلاء على الأجهزة المحلية
أما Nemotron 3.5 Bolt 74B-A9B 24GB فيضم 74 مليار معلمة إجمالاً، منها تسعة مليارات نشطة، وقد طُوّر بضغط النموذج الأكبر وإعادة تدريبه. ويستخدم ضغطاً يقارب بتّين لأجزاء رئيسية من الأوزان، بهدف احتواء النموذج ضمن ميزانية ذاكرة تبلغ 24 غيغابايت.
وتستهدف هذه النسخة أعمالاً يومية مثل البحث وكتابة الشيفرة وتصحيحها على أنظمة RTX وDGX Spark. ويشير اسم 24GB إلى هدف مساحة النموذج، لذلك ينبغي مراجعة إعداد التشغيل الفعلي، بما فيه السياق والبرامج المصاحبة، قبل اعتبار الرقم ضماناً لكفاية الذاكرة في كل حالة.
وتنشر إنفيديا معه نموذجاً مساعداً لتسريع توليد الرموز، ونسخة BF16 قابلة لمزيد من التخصيص، وأوزاناً بصيغة GGUF. وفي اختبار الشركة على جهاز RTX Spark محدد، قاربت سرعة التوليد 84 رمزاً في الثانية؛ وهي نتيجة خاصة بالعتاد والبرمجيات وإعدادات الاختبار الموثقة، وليست قياساً أجرته التقنية السورية.
ماذا يعني ادعاء السرعة الأعلى بخمسة أضعاف؟
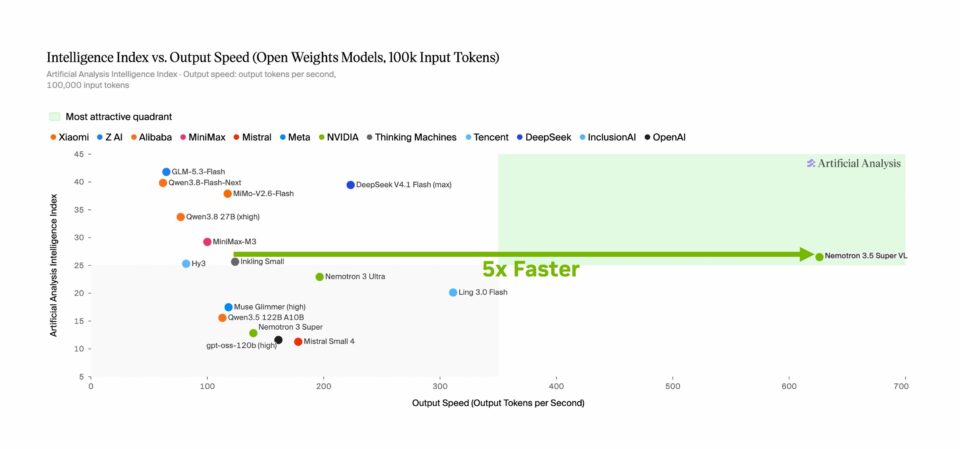
تقول إنفيديا إن Super VL يحقق إنتاجية أعلى بما يصل إلى خمسة أضعاف مقارنة بنماذج مفتوحة ضمن فئته. ويعرض المخطط المنشور مقارنة لسرعة إخراج الرموز عند مدخلات من 100 ألف رمز، مع إبراز الفارق أمام Inkling Small.
وتختلف سرعة توليد الرموز عن الزمن اللازم لإكمال مهمة كاملة، والذي يتأثر بعدد الخطوات واستدعاءات الأدوات وطول الإجابات. لذلك ينبغي قراءة النتيجة ضمن ظروف القياس المحددة، وعدم تعميمها على كل تطبيق أو استخدامها للقول إن النموذج يتفوق على جميع المنافسين في كل جانب.

تخصيص للمؤسسات وإتاحة على مراحل
تتيح أدوات NVIDIA NeMo تكييف Super VL بالتدريب الإضافي ومواءمة النموذج مع بيانات المؤسسة وسياساتها. كما نشرت الشركة مجموعات بيانات تشمل استخدام الأدوات وفهم المستندات والمحادثات، لدعم تطوير وكلاء متخصصين. وتخضع النسخة الموثقة من Super VL لترخيص OpenMDW 1.1، مع إتاحتها للاستخدام التجاري وغير التجاري وفق شروطه.
يمكن الوصول إلى Super VL عبر Hugging Face وOpenRouter وModelScope، وكذلك NVIDIA NIM. أما Bolt 74B-A9B فيتوفر مع دعم أدوات تشغيل مثل llama.cpp وOllama وLM Studio وvLLM، ما يوسع خيارات تجربته محلياً.
ويبقى Bolt E4B 4GB الإصدار المنتظر في 23 أكتوبر، والموجّه للمساعدات الحوارية والتفاعلات الصوتية والواجهات المدمجة على منصات تشمل GeForce RTX وJetson وDGX Spark. وبذلك يجب الفصل بين النماذج التي يمكن تنزيلها الآن، والنسخة الأصغر التي أعلنت الشركة موعد وصولها لاحقاً.