

أعلنت جوجل في 14 تشرين الأول/أكتوبر إطلاق Deep Review للجمهور، وهي أداة ذكاء اصطناعي لفحص المستندات المعقدة واقتراح تحسينات عليها. وتأتي الخدمة امتداداً لأداة Paper Assistant Tool البحثية، بعد تجارب شملت أكثر من 16 ألف مخطوطة علمية، وفق الشركة.
مراجعتان مجانيتان أسبوعياً
تتيح الخدمة مراجعتين مجانيتين أسبوعياً لكل مستخدم، وتدعم مبدئياً ملفات PDF والنصوص العادية. ويمكن ربط مفتاح Gemini API لزيادة حدود الاستخدام والوصول البرمجي، فيما لا يزال دعم المدخلات المتعددة الملفات ضمن الميزات المرتقبة.
وتشمل الاستخدامات المقترحة مستندات التصميم والعروض التقديمية والوثائق القانونية والمالية. وتؤكد جوجل أن الملفات المرفوعة لا تُستخدم لتدريب نماذجها أو تحسينها، لكنها تُخزّن عاماً واحداً لعرضها للمستخدم داخل الواجهة. وهذه نقطة تستحق الانتباه قبل رفع مستندات حساسة. المصدر: إعلان Google Research.
كيف تراجع الأداة المستندات؟
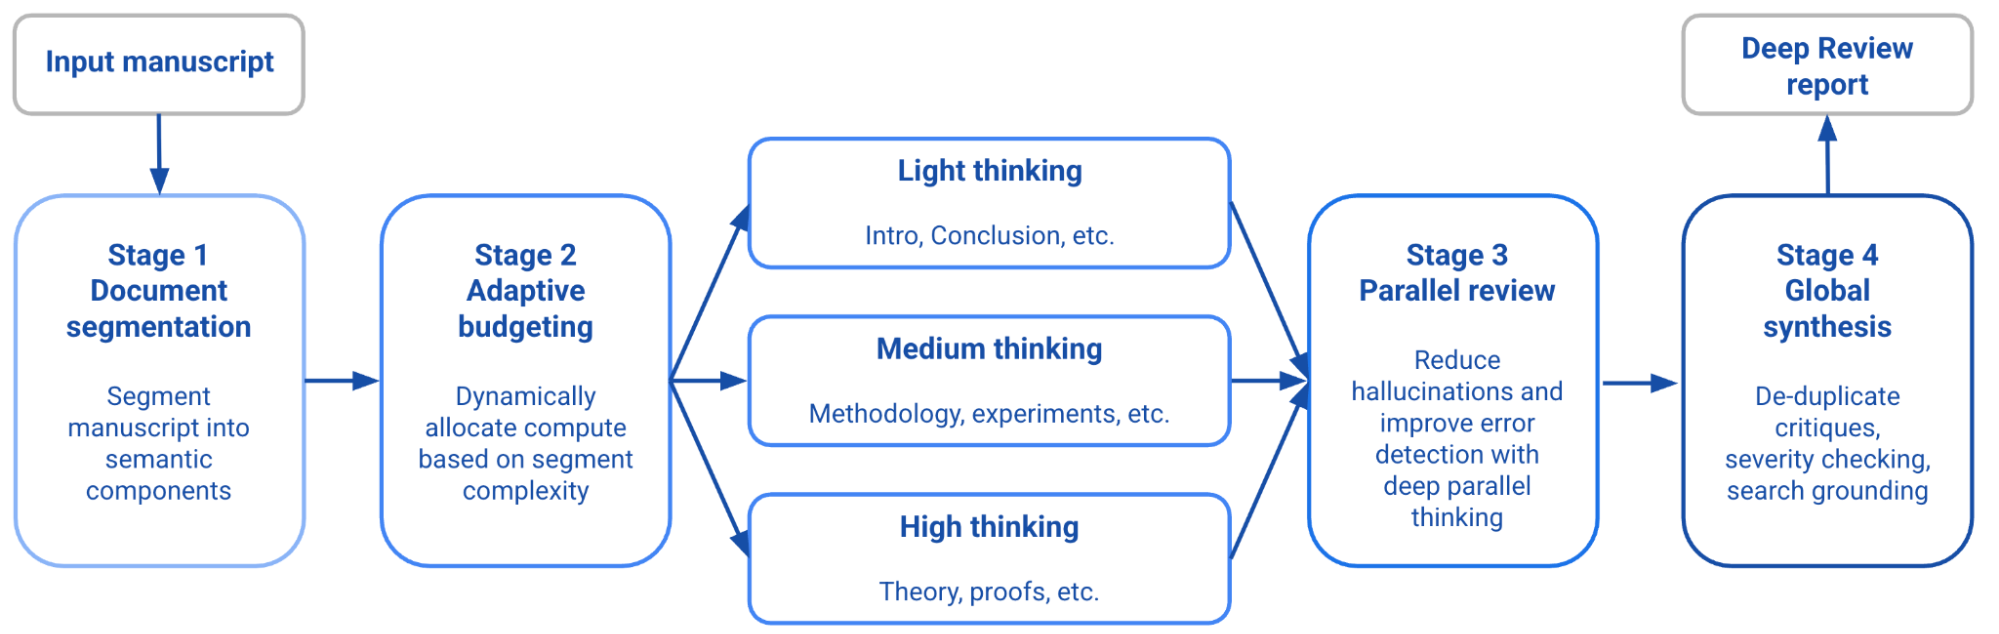
تشرح الورقة البحثية الخاصة بالأداة السابقة PAT الأساس التقني لهذا النهج: يبدأ النظام بتقسيم الورقة إلى أجزاء مترابطة منطقياً، وقد تتداخل هذه الأجزاء عند الحاجة. ثم يوزع الموارد الحاسوبية بحسب صعوبة المحتوى، بحيث يحصل البرهان الرياضي الكثيف على قدر من المعالجة يختلف عما تحتاجه فقرة أبسط.
بعد ذلك، تفحص أدوات متخصصة الأجزاء بصورة متوازية. ويطّلع كل وكيل على المستند كاملاً لفهم السياق، مع تركيز التدقيق على الجزء المسند إليه. وفي النهاية، تجمع مرحلة أخرى الملاحظات وتستخدم البحث للتحقق من الإحالات وتقليل احتمالات الاستشهاد بأبحاث أو نظريات غير موجودة.
وفي اختبار بحثي على مجموعة محدودة ضمت 26 ورقة و29 خطأً رياضياً أو برهانياً، سجلت PAT نسبة اكتشاف بلغت 89.7%، مقابل 55.2% لاستدعاء منفرد لنموذج Gemini 3.1 Pro. وهذه نتيجة لتجربة محددة على النسخة البحثية؛ فلا تمثل ضماناً لاكتشاف جميع الأخطاء في أي مستند، ولا قياساً شاملاً لأداء الخدمة العامة الجديدة. المصدر: الورقة البحثية.
ماذا أظهرت التجارب السابقة؟
تقدم تجربة ICML 2026 صورة عملية عن نوع الفائدة المحتملة. فقد أتاحت الأداة ملاحظات لنحو 4500 ورقة خلال برنامج أُجري في كانون الثاني/يناير، وبلغ متوسط وصول الردود نحو نصف ساعة. ويخص هذا التوقيت تلك التجربة تحديداً، ولا ينبغي اعتباره وعداً بسرعة الخدمة الحالية.
وبحسب التقرير المنشور على مدونة المؤتمر، أجاب 869 مشاركاً عن الاستبيان اللاحق، وقال 92.1% إنهم سيستخدمون الأداة مجدداً. كما أفاد 35.4% من أصحاب الأوراق التي تتضمن نتائج نظرية بأن الملاحظات كشفت ثغرات مهمة استغرق إصلاحها أكثر من ساعة، بينما دفعت الملاحظات 31% من أصحاب النتائج التجريبية إلى إجراء تجارب جديدة.
وتشير هذه النتائج إلى ملاحظات تتجاوز تصحيح الصياغة والأخطاء المطبعية. لكنها تعكس إجابات المشاركين في الاستبيان، وليست حكماً مستقلاً على دقة كل مراجعة. وكانت الملاحظات خاصة بالمؤلفين ومنفصلة تماماً عن التحكيم الرسمي، ولم تُتح للمراجعين أو لرئاسة البرنامج. المصدر: تقرير ICML.
وفي تجربة STOC الأقدم، تناولت الملاحظات مشكلات مثل عدم اتساق أسماء المتغيرات، وأخطاء الحساب، واستخدام المتباينات، والفجوات المنطقية في البراهين. وقد تسلم الباحثون تقارير منظمة تضم ملخصاً لإسهامات الورقة، وملاحظات على الأخطاء المحتملة، وتصحيحات أصغر. غير أن جوجل أوضحت أيضاً أن المشاركين اضطروا إلى فرز الملاحظات والتحقق منها، خصوصاً عندما واجه النموذج صعوبة في قراءة الرموز المعقدة أو تفسير الأشكال. المصدر: تجربة STOC.
وللأداة جانب تعليمي أيضاً؛ إذ رأى 75% من المشاركين الذين شملهم استبيان تجربة STOC قيمة تعليمية فيها للطلاب، من خلال الملاحظات السريعة على صرامة البراهين ووضوح العرض. ويعطي ذلك مثالاً على استخدامها خلال إعداد المسودة، حين يكون لدى الكاتب وقت لفهم الاعتراضات ومراجعة خطواته، بدلاً من التعامل مع التقرير الآلي بوصفه شهادة نهائية بصحة العمل. المصدر: تقرير STOC المشار إليه أعلاه.
المراجعة البشرية تبقى ضرورية
يوضح برنامج NeurIPS السابق حدود هذه الفكرة بوضوح: قد تعتبر الأداة عبارة صحيحة خطأً، وقد تفوتها مشكلة حقيقية. لذلك تقع على المؤلف مسؤولية التأكد من صحة الملاحظات قبل تعديل بحثه بناءً عليها.
وشملت تحسينات ذلك البرنامج أدوات بحث وتحقق أفضل، ومقارنة أوسع بالأعمال السابقة، وتحليلاً لنقاط القوة والضعف. ومع ذلك، أكد المنظمون أن الهدف هو مساعدة المؤلفين على تحسين أوراقهم قبل تقديمها، مع إبقاء عملية التحكيم مستقلة. وبناءً على هذه الحدود، تبدو المراجعة الآلية مرحلة إضافية نافعة لاختبار المستند وطرح أسئلة عليه، مع بقاء الحكم النهائي على صحة المحتوى لدى صاحبه والخبراء المختصين. المصدر: برنامج NeurIPS.